重症医学专科复习题中的 ChatGPT-4o:准确率高,但多模态解读存在风险
要点提示
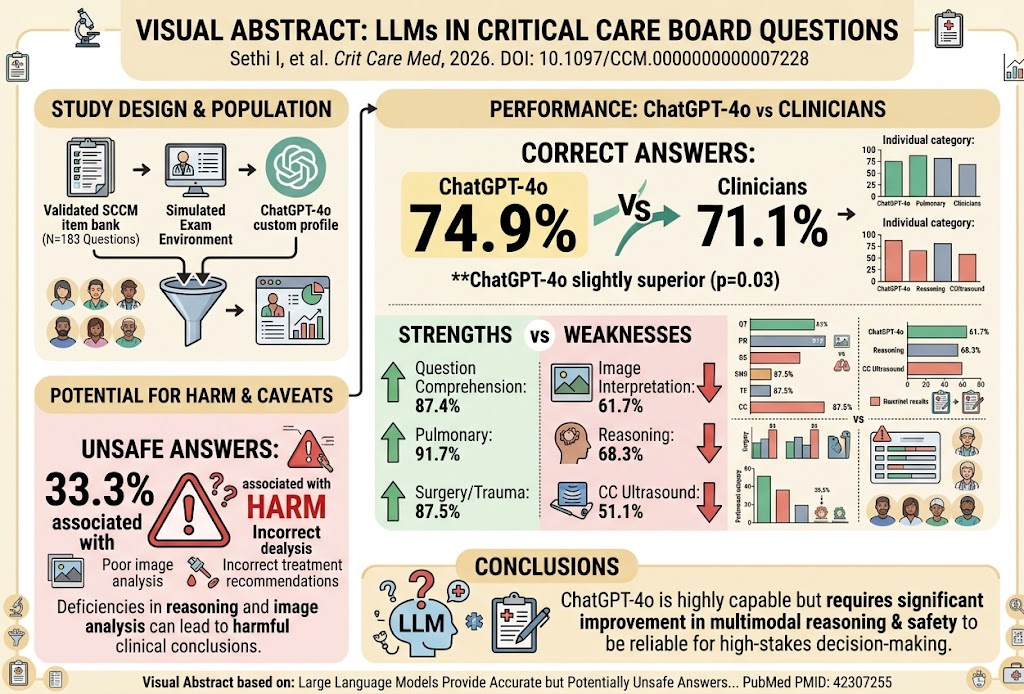
ChatGPT-4o 在重症医学专科委员会复习题中的总体正确率略高于临床医师汇总答案;但其图像解读和临床推理能力存在明显不足,在高风险场景中可能带来安全性与可靠性隐患。该模型在肺部与外科领域表现较强,但在重症超声图像解读方面结果较差。约三分之一的 AI 回答因错误而具有潜在临床危害风险。
研究背景
MedXY 注册用户
免费登录后阅读全文
登录或注册 MedXY 账号,即可解锁本文完整内容。
本文在创作过程中使用了包括 AI 在内的多种编辑工具,并在发布前经人工编辑审核。