ChatGPT-4o trong các câu hỏi ôn tập chuyên ngành Y học Hồi sức tích cực: Độ chính xác cao nhưng tiềm ẩn rủi ro trong việc diễn giải đa phương thức
Điểm nổi bật
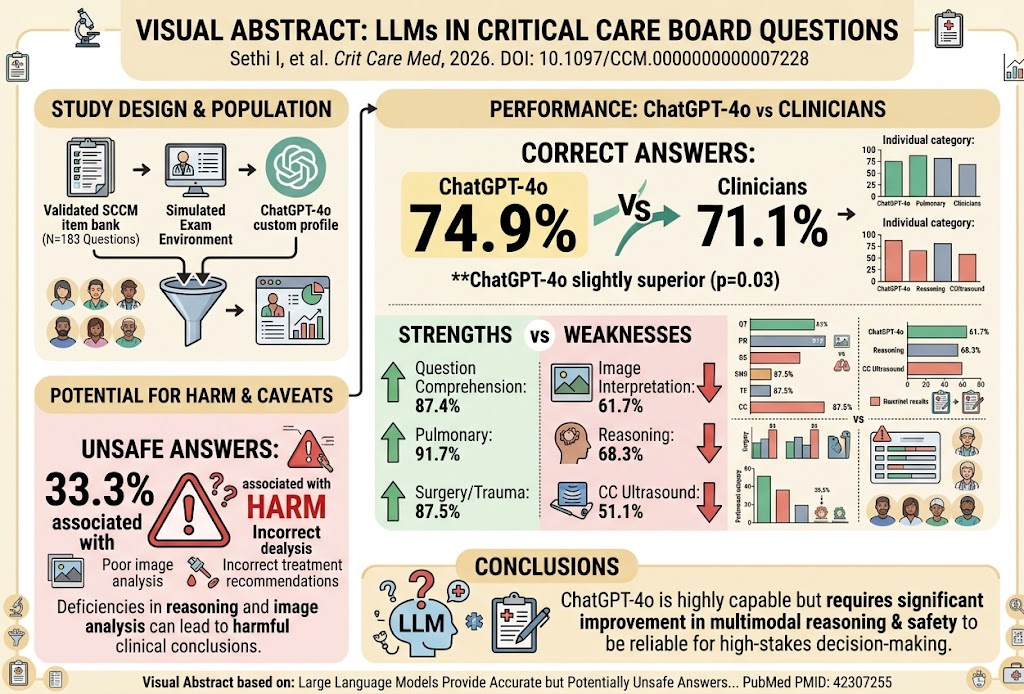
ChatGPT-4o cho thấy độ chính xác nhỉnh hơn một chút so với kết quả trả lời gộp từ các bác sĩ lâm sàng trên các câu hỏi kiểu ôn thi hội đồng về hồi sức cấp cứu; tuy nhiên, năng lực diễn giải hình ảnh và lập luận lâm sàng còn hạn chế đáng kể, làm dấy lên lo ngại về tính an toàn và độ tin cậy trong các bối cảnh có rủi ro cao. Mô hình thể hiện hiệu quả tốt trong các lĩnh vực hô hấp và ngoại khoa, nhưng kết quả lại kém trong diễn giải siêu âm hồi sức cấp cứu. Khoảng một phần ba câu trả lời của AI tiềm ẩn nguy cơ gây hại lâm sàng do sai sót.
Bối cảnh nghiên cứu
Y học hồi sức cấp cứu đòi hỏi đưa ra quyết định nhanh chóng, dựa trên bằng chứng và tích hợp nhiều loại dữ liệu, bao gồm phát hiện lâm sàng, giá trị xét nghiệm và các thăm dò hình ảnh khác nhau. Kỳ thi chứng nhận chuyên khoa hồi sức cấp cứu yêu cầu năng lực diễn giải thông tin đa phương thức phức tạp. Các mô hình ngôn ngữ lớn (LLM, Large Language Models) như ChatGPT-4o đã cho thấy tiềm năng trong đánh giá kiến thức y khoa, nhưng ít được đánh giá hơn về khả năng diễn giải các câu hỏi đa phương thức có kèm hình ảnh lâm sàng—một kỹ năng thiết yếu trong chẩn đoán và xử trí hồi sức cấp cứu.
Trong bối cảnh ngày càng quan tâm đến việc tận dụng AI cho giáo dục lâm sàng và hỗ trợ quyết định, việc đánh giá nghiêm ngặt độ chính xác, khả năng lập luận và tính an toàn của LLM trong các tình huống lâm sàng liên quan đến hồi sức cấp cứu là rất cần thiết. Việc diễn giải sai hoặc đưa ra khuyến nghị không phù hợp từ các công cụ AI trong bối cảnh này có thể gây hại nếu được đưa vào quá trình ra quyết định hoặc giáo dục mà không có giám sát chặt chẽ của con người.
Thiết kế nghiên cứu
Nghiên cứu quan sát này đánh giá hiệu năng của ChatGPT-4o bằng 183 câu hỏi trắc nghiệm từ ngân hàng câu hỏi của Society of Critical Care Medicine. Các câu hỏi bao quát nhiều lĩnh vực hồi sức cấp cứu khác nhau và có nội dung đa phương thức—kết hợp văn bản với các hình ảnh lâm sàng liên quan như phim X-quang và siêu âm.
Một cấu hình ChatGPT-4o tùy chỉnh đã được phát triển dựa trên một khung đã được thẩm định, được thiết kế để mô phỏng điều kiện của kỳ thi hội đồng chuyên khoa hồi sức cấp cứu. Mười bốn bác sĩ lâm sàng giàu kinh nghiệm trong lĩnh vực hồi sức cấp cứu, bao gồm bác sĩ, nhân viên thực hành nâng cao và dược sĩ, đã xem xét các câu trả lời của AI về độ chính xác, chất lượng diễn giải hình ảnh, lập luận lâm sàng và nguy cơ gây hại cho người bệnh.
Không có can thiệp nào được áp dụng ngoài việc AI trả lời câu hỏi; bối cảnh nghiên cứu mô phỏng môi trường thi nhằm đối chiếu ChatGPT-4o với hiệu năng của bác sĩ lâm sàng.
Kết quả chính
Độ chính xác chung: ChatGPT-4o đạt tỷ lệ trả lời đúng 74,9%, cao hơn có ý nghĩa thống kê so với tỷ lệ trả lời đúng gộp của bác sĩ lâm sàng là 71,1% (p = 0,03). Điều này cho thấy mô hình có năng lực tốt về kiến thức y khoa và khả năng hiểu câu hỏi.
Hiệu năng theo lĩnh vực: Độ chính xác cao nhất được ghi nhận ở bệnh phổi (91,7%), ngoại khoa và chấn thương (87,5%), và rối loạn thần kinh (81,8%). Ở các lĩnh vực này, việc hiểu câu hỏi tương đối tốt, nhưng độ chính xác giảm khi yêu cầu diễn giải hình ảnh.
Diễn giải hình ảnh: Hiệu năng của AI ở mức chưa tối ưu, với khả năng diễn giải hình ảnh đúng chỉ trong 61,7% trường hợp. Kết quả đặc biệt kém ở các câu hỏi về siêu âm hồi sức cấp cứu, với độ chính xác chỉ 51,1%. Những phát hiện này nhấn mạnh thách thức của LLM trong xử lý dữ liệu lâm sàng trực quan.
Lập luận lâm sàng và hỗ trợ: ChatGPT-4o cho thấy chất lượng lập luận ở mức trung bình (68,3%) và mức độ đầy đủ khi cung cấp thông tin hỗ trợ là 66,1%. Điều này cho thấy mặc dù mô hình hiểu tốt nội dung câu hỏi, nhưng khả năng tích hợp và vận dụng kiến thức y khoa vào lập luận vẫn còn hạn chế.
Nguy cơ gây hại: Đáng lưu ý, 33,3% các câu trả lời do AI tạo ra có liên quan đến nguy cơ gây hại lâm sàng, chủ yếu do diễn giải hình ảnh sai và khuyến nghị điều trị không phù hợp. Điều này đặt ra các mối lo ngại nghiêm trọng về an toàn khi dựa vào LLM trong ra quyết định lâm sàng hoặc giáo dục mà không có xác minh từ con người.
Bình luận chuyên gia
Nghiên cứu này là một trong những nghiên cứu đầu tiên đánh giá một cách nghiêm ngặt khả năng của một LLM tiên tiến trong việc xử lý các câu hỏi hồi sức cấp cứu đa phương thức trong điều kiện giống kỳ thi. Độ chính xác chung cao hơn so với nhóm bác sĩ lâm sàng gộp cho thấy khả năng ấn tượng của ChatGPT-4o trong việc tiếp thu lượng lớn kiến thức y khoa. Tuy nhiên, năng lực còn hạn chế của AI trong diễn giải hình ảnh lâm sàng—một nền tảng của thực hành hồi sức cấp cứu—lại cho thấy một khoảng trống quan trọng.
Các sai sót ở câu hỏi dựa trên hình ảnh và trong lập luận có thể liên quan đến những giới hạn vốn có của kiến trúc LLM hiện tại, vốn chủ yếu tập trung vào xử lý văn bản và được huấn luyện ít hơn trên dữ liệu hình ảnh hoặc việc tích hợp dữ liệu này vào bối cảnh lâm sàng. Nguy cơ đáng kể từ các khuyến nghị có thể gây hại nhấn mạnh nhu cầu phải thẩm định nghiêm ngặt trước khi đưa những mô hình như vậy vào quy trình làm việc lâm sàng hoặc các công cụ đánh giá giáo dục.
Các cải tiến trong tương lai có thể bao gồm các phương pháp huấn luyện đa phương thức được thiết kế rõ ràng để tích hợp hình ảnh lâm sàng và chẩn đoán với lập luận dựa trên văn bản. Cho đến khi đạt được điều đó, bác sĩ lâm sàng và nhà giáo dục nên tiếp cận đầu ra của LLM một cách thận trọng, bảo đảm có sự giám sát của con người nhằm giảm thiểu nguy cơ.
Kết luận
ChatGPT-4o cho thấy độ chính xác đầy hứa hẹn, vượt qua hiệu năng trung bình của bác sĩ lâm sàng trên các câu hỏi ôn thi hội đồng đa phương thức trong hồi sức cấp cứu, nhưng lại chưa đáp ứng ở các lĩnh vực then chốt là diễn giải hình ảnh và lập luận lâm sàng. Những hạn chế này góp phần tạo ra một tỷ lệ đáng kể các khuyến nghị có khả năng không an toàn, qua đó nhấn mạnh sự cần thiết phải áp dụng thận trọng trong môi trường lâm sàng.
Mặc dù LLM có tiềm năng như công cụ hỗ trợ giáo dục hoặc hỗ trợ ra quyết định, các hạn chế hiện tại đòi hỏi phải được chuyên gia con người xem xét. Việc tiếp tục phát triển khả năng tích hợp xử lý dữ liệu hình ảnh và lập luận lâm sàng phức tạp sẽ là yếu tố thiết yếu để khai thác các công nghệ này một cách an toàn và hiệu quả trong y học hồi sức cấp cứu.
Tài trợ và thử nghiệm lâm sàng
Nghiên cứu được trích dẫn được công bố mà không nêu rõ nguồn tài trợ và không báo cáo bất kỳ thử nghiệm lâm sàng can thiệp nào.
Tài liệu tham khảo
1. Sethi I, Khan S, Lyons PG, et al. Large Language Models Provide Accurate but Potentially Unsafe Answers to Multimodal Critical Care Medicine Board Review Questions. Crit Care Med. 2026;54(9):2245-2255. PMID: 42307255.
2. Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
3. Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
4. Langlotz CP, Allen B, Erickson BJ, et al. A roadmap for foundational research on artificial intelligence in medical imaging: From the 2018 NIH/RSNA/ACR/The Academy Workshop. Radiology. 2019;291(3):781-791.
Bài viết này được tạo với sự hỗ trợ của nhiều công cụ biên tập, bao gồm AI, trong quá trình thực hiện. Nội dung đã được biên tập viên xem xét trước khi xuất bản.