“完成良好”并不等于同样出色:内科住院医师虚拟与线下OSCE沟通技能评估差异解析
研究亮点
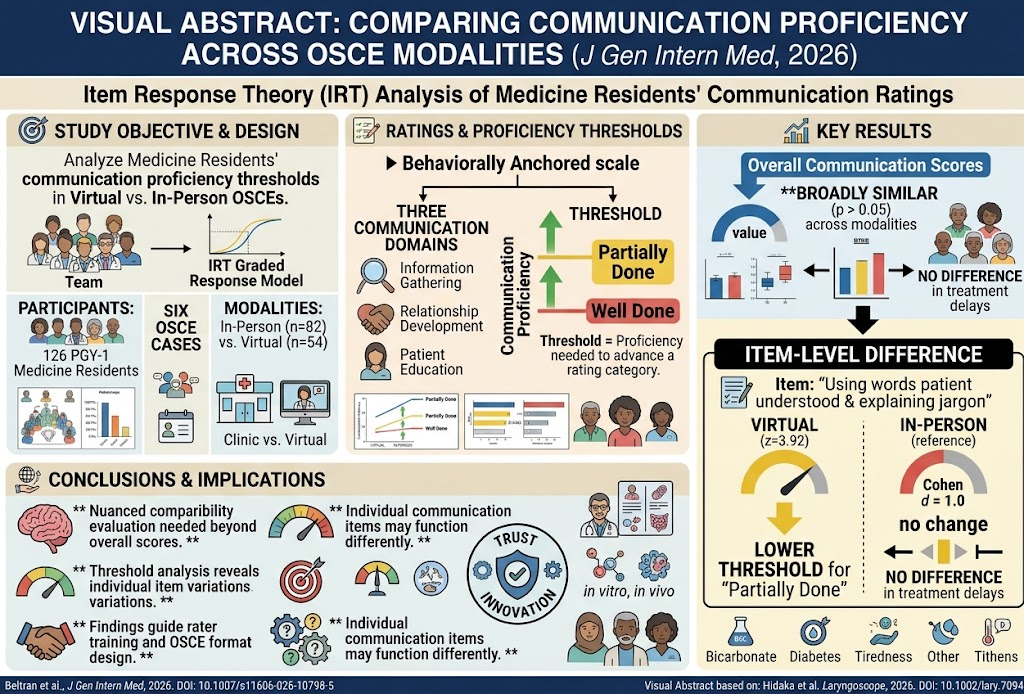
本研究采用项目反应理论(Item Response Theory,IRT),对内科住院医师在虚拟与线下客观结构化临床考试(Objective Structured Clinical Examination,OSCE)中的沟通技能评估进行了分析。结果显示,尽管两种形式下总体沟通评分相近,但在具体沟通条目上仍存在能力阈值差异,尤以“解释医学术语”这一能力最为明显。这提示在不同考试形式下,对沟通技能的评估需要更加细致和有针对性。
研究背景
临床沟通能力的评估是医学培训与执业资格认证中的关键组成部分。客观结构化临床考试(OSCE)是一种广泛应用的评估工具,借助标准化病人(standardized patients,SPs)和行为锚定评分量表,测量特定的临床与沟通能力。OSCE传统上以线下形式开展,而在2019冠状病毒病(COVID-19)疫情推动下,虚拟OSCE迅速普及,因其灵活性和可及性优势而受到重视。然而,既往研究主要比较虚拟与线下OSCE的总体成绩,尚未深入分析不同沟通行为在两种形式下是否具有同等的评估标准。若忽视这一问题,可能掩盖能力展示或评分中的细微差异,从而影响基于OSCE评估的效度与公平性。
研究设计
本研究分析了126名内科住院医师一年级(PGY-1)学员的数据,这些学员在2019年至2023年间接受了6次基于病例的OSCE评估。其中,82次为线下考核,54次为虚拟考核。为保证一致性,两种形式均使用相同的内科病例。标准化病人从3个维度对住院医师的沟通表现进行评分:信息收集、关系建立和患者教育。评分采用行为锚定量表,设有3个有序等级:“未完成”“部分完成”或“完成良好”。结局指标包括各维度平均得分、评分分布,以及最关键的、基于分级反应项目反应理论(graded response IRT)模型估计的单条目能力阈值。该方法可量化在每个条目上,从一个评分等级过渡到下一个评分等级所需的潜在沟通能力水平。通过Wald检验比较两种模式下的阈值差异,可识别在虚拟与线下情境中表现不同的条目。
主要发现
虚拟与线下OSCE的总体沟通评分及评分分布均无显著差异,提示两种形式在总体表现层面具有可比性。大多数住院医师在多数检查表条目上均表现出足够的沟通能力,可获得“部分完成”或“完成良好”的评分。
然而,单条目IRT阈值分析显示,某一特定沟通行为——“使用患者能理解的词语并解释医学术语”——在不同考试形式之间所需的能力水平存在显著差异。对于该条目,相较于线下情境,住院医师在虚拟情境中达到“部分完成”评分所需的潜在沟通能力更低(z = 3.92,校正后p = 0.001)。这提示,虚拟形式可能使该技能更容易获得基础认可,也可能反映评分者在虚拟评估中采用了不同标准,或对该行为的感知不同。其他沟通条目未见统计学显著的阈值差异。
这些结果表明,尽管总体得分模式相似,但特定评分的含义,尤其是细微沟通行为的评分含义,可能并非在所有OSCE形式中都完全一致。对于在虚拟与线下OSCE之间切换或联合使用的教育者和项目负责人而言,这一点在解读纵向或比较性评估结果时尤为重要。
专家点评
将项目反应理论应用于临床技能评估,可提供超越总体分数的精细化分析框架。本研究很好地展示了IRT阈值参数如何揭示与OSCE考试形式相关的、潜在的沟通能力标准差异。
在解释医学术语方面观察到的差异,可能源于虚拟情境特有的挑战,例如患者线索变化、音视频限制,或互动方式改变,这些因素可能放大或掩盖住院医师在该领域的真实能力。另一种可能是,标准化病人因考试形式不同而采用了不同的评分预期或感知。未来研究若能结合评分者培训标准化与定性反馈,将有助于进一步阐明这些机制。
更重要的是,本研究提醒医学教育者:在缺乏更细粒度心理测量学分析的情况下,不应默认不同OSCE形式之间的分数可以直接等同。随着虚拟评估日益普及,IRT阈值分析等工具可为效度论证提供支持,并有助于制定更有针对性的形成性反馈、补救训练和终结性判断策略。
结论
本研究提供了有意义的证据:尽管内科OSCE中总体沟通能力评分在虚拟与线下形式之间看似相近,但具体沟通行为的评分水平可能因情境不同而有所差异。解释医学术语能力上观察到的差异,提示临床沟通评估中可能存在形式特异性的偏倚或交互效应。在OSCE效度验证中引入项目反应理论阈值分析,可进一步拓展对评分等同性的理解,并有助于确保无论考试形式如何变化,都能对住院医师的沟通技能作出公平、准确的评价。医学教育项目在设计、解读以及虚拟与线下OSCE转换过程中,应充分考虑这些差异,以维护沟通技能评估的严谨性与实际意义。
经费与ClinicalTrials.gov
原文未说明经费来源或临床试验注册信息。
参考文献
Beltran CP, Nallamaddi S, Wilhite JA, Hardowar K, Hanley K, Altshuler L, Zabar SR, Gillespie C. When
本文在创作过程中使用了包括 AI 在内的多种编辑工具,并在发布前经人工编辑审核。