集中治療ボード試験でのChatGPT-4o評価:高精度だがマルチモーダル解釈に課題
注目ポイント
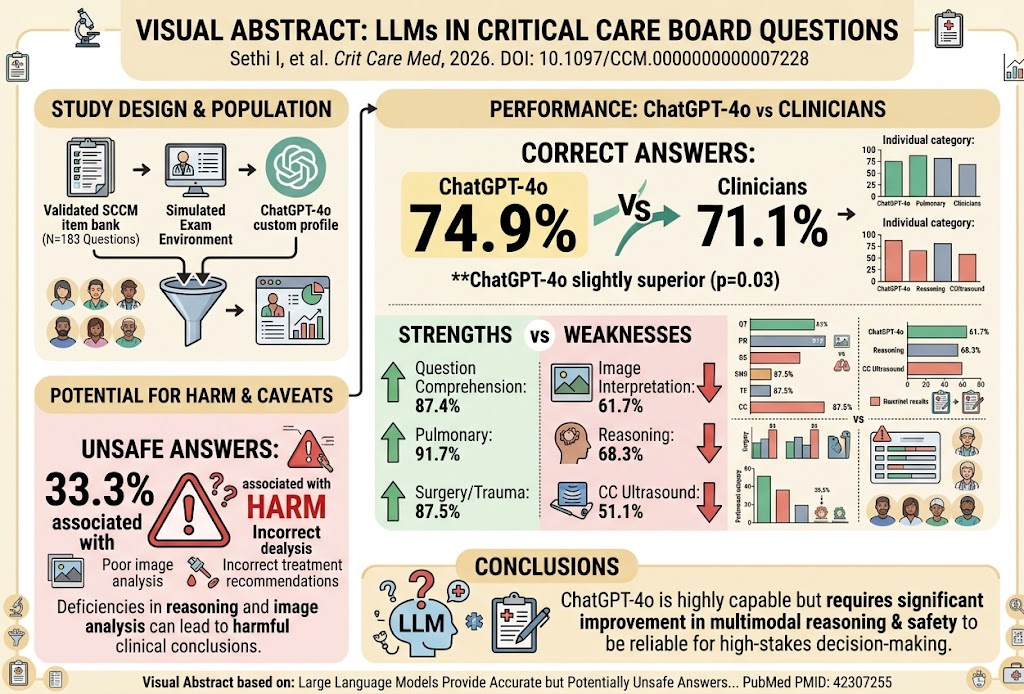
ChatGPT-4oは、集中治療のボード試験形式の設問において、臨床医の回答を集計した成績よりわずかに高い正答率を示した。一方で、画像解釈と臨床推論に明らかな弱点があり、高リスクな状況では安全性と信頼性に懸念が残る。肺疾患および外科領域では良好な成績を示したのに対し、集中治療超音波の解釈では不良であった。AI応答の約3分の1は、誤りにより臨床的有害性を伴うリスクがあると評価された。
研究背景
集中治療医学では、臨床所見、検査値、各種画像検査など、複数のデータモダリティを統合した迅速かつエビデンスに基づく意思決定が求められる。集中治療の認定試験では、複雑なマルチモーダル情報を解釈する能力が必須である。ChatGPT-4oのような大規模言語モデル(large language model、LLM)は、医学知識の評価において有望性を示しているが、臨床画像を含むマルチモーダルな設問を解釈する能力については、これまで十分に評価されてこなかった。これは集中治療の診断および管理において極めて重要な技能である。
臨床教育や意思決定支援へのAI活用への関心が高まる中、集中治療に関連する臨床シナリオにおけるLLMの正確性、推論能力、安全性を厳密に評価することは不可欠である。この文脈でAIツールが誤った解釈や不適切な推奨を示した場合、批判的な監視なしに意思決定や教育へ組み込まれると、有害な結果をもたらす可能性がある。
研究デザイン
本観察研究では、Society of Critical Care Medicineの問題バンクから抽出した183問の多肢選択問題を用いて、ChatGPT-4oの成績を評価した。設問は多様な集中治療領域を含み、X線画像や超音波画像などの関連臨床画像とテキストを組み合わせたマルチモーダル内容を含んでいた。
検証済みの枠組みに基づき、集中治療ボード試験の条件を再現するように調整したChatGPT-4oのカスタムプロファイルが作成された。医師、高度実践看護職、薬剤師を含む14名の経験豊富な集中治療医療従事者が、AI応答の正確性、画像解釈の質、臨床推論、および患者有害事象の可能性を評価した。
AIによる設問回答以外の介入は行われず、環境は試験状況を模擬し、ChatGPT-4oと人間の臨床医の成績を比較するよう設定された。
主な結果
全体的な正確性:ChatGPT-4oの正答率は74.9%であり、臨床医の回答を集計した正答率71.1%を統計学的に上回った(p = 0.03)。これは、本モデルが優れた医学知識と理解能力を有することを示唆する。
領域別成績:最も高い正確性は、肺疾患(91.7%)、外科・外傷(87.5%)、神経疾患(81.8%)で認められた。これらの領域では設問理解は良好であったが、画像解釈が必要となると正確性は低下した。
画像解釈:AIの成績は十分とはいえず、画像を正しく解釈できたのは61.7%にとどまった。特に集中治療超音波の設問では51.1%と低値であった。これらの結果は、LLMが視覚的な臨床データを処理するうえで課題を抱えることを示している。
臨床推論と補足説明:ChatGPT-4oは中等度の推論品質(68.3%)と、根拠となる情報の提示の妥当性(66.1%)を示した。これは、設問内容の理解は良好である一方、医学知識を統合して推論に適用する能力には限界があることを示している。
有害性の可能性:重要な点として、AI生成回答の33.3%は臨床的有害性の可能性と関連しており、その主因は誤った画像解釈と不適切な治療推奨であった。これは、人による検証なしにLLMを臨床意思決定や教育に依拠することへの重大な安全性の懸念を提起する。
専門家コメント
本研究は、最先端LLMが試験に近い条件下でマルチモーダルな集中治療設問を扱う能力を批判的に評価した、初期の研究の一つである。臨床医の回答を集計した成績を上回る全体正確性は、ChatGPT-4oが膨大な医学知識を統合する高い能力を持つことを示している。しかし、集中治療実践の要である臨床画像の解釈能力が限定的であることは、重要なギャップを示している。
画像ベースの設問や推論における誤りは、主としてテキスト処理に重点を置き、視覚データやその臨床的統合に関する学習が相対的に少ない現行LLMアーキテクチャ固有の限界に起因する可能性がある。潜在的に有害な助言のリスクが大きいことは、こうしたモデルを臨床ワークフローや教育評価ツールに導入する前に、厳密な検証が必要であることを強く示唆する。
今後の改善には、臨床画像と診断情報をテキストベースの推論と明示的に統合するよう設計されたマルチモーダルトレーニングの枠組みが必要となる可能性がある。それまでは、臨床医および教育者はLLMの出力を慎重に扱い、人による監督を通じてリスクを軽減すべきである。
結論
ChatGPT-4oは、マルチモーダルな集中治療ボード設問において平均的な臨床医の成績を上回る有望な正確性を示したが、画像解釈と臨床推論という中核領域では不十分であった。これらの欠点により、安全性に懸念のある推奨が一定割合で生じており、臨床現場での慎重な適用が求められる。
LLMは教育補助や意思決定支援ツールとしての可能性を有する一方、現時点では専門家による人間のレビューが不可欠である。視覚データ処理と複雑な臨床推論を統合するさらなる開発が、集中治療医学においてこれらの技術を安全かつ効果的に活用するために重要となる。
資金提供と臨床試験
引用された研究は資金提供 स्रोतが開示されないまま公表されており、介入を伴う臨床試験は報告されていない。
参考文献
1. Sethi I, Khan S, Lyons PG, et al. Large Language Models Provide Accurate but Potentially Unsafe Answers to Multimodal Critical Care Medicine Board Review Questions. Crit Care Med. 2026;54(9):2245-2255. PMID: 42307255.
2. Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
3. Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
4. Langlotz CP, Allen B, Erickson BJ, et al. A roadmap for foundational research on artificial intelligence in medical imaging: From the 2018 NIH/RSNA/ACR/The Academy Workshop. Radiology. 2019;291(3):781-791.
この記事は、制作工程の一部でAIを含む複数の編集ツールを使用して作成され、公開前に人間の編集者が内容を確認しています。